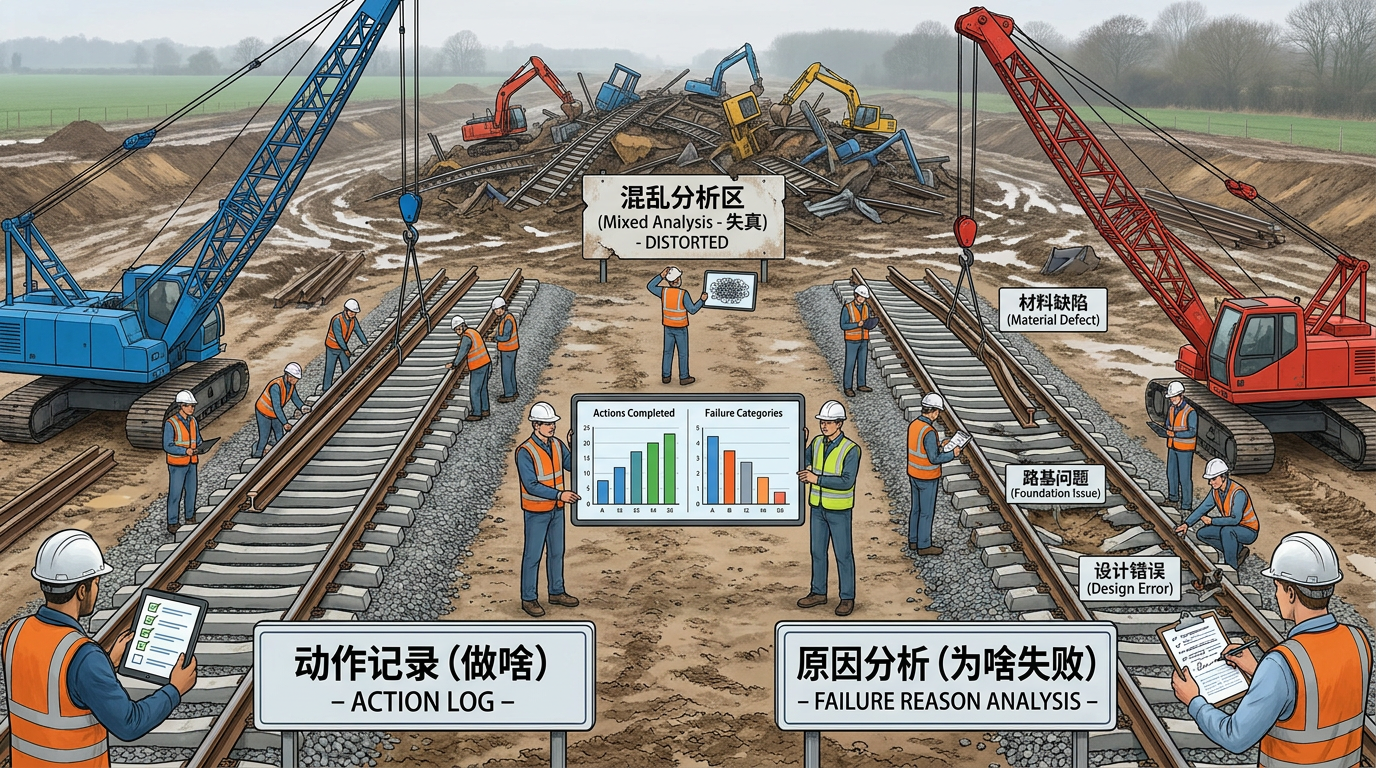
将操作意图与故障反馈分开统计,能避免分析失真,确保识别具体失败原因以制定针对性优化策略。
为什么要分开统计操作需求与故障反馈?
快速答案:“如何操作”和“操作失败”可能需要不同的内容与处理方式。分开记录用户任务、查询意图、产品环境和观察到的现象,有助于判断应优化指南、修复搜索入口、解释使用限制,还是转交产品或支持团队调查。但分类本身不能证明故障原因,仍需结合工单上下文和实际验证。
| 记录层面 | 需要回答的问题 | 示例 |
|---|---|---|
| 任务与意图 | 用户想完成什么,还是遇到了什么阻碍? | 如何导出报表;导出失败怎么办 |
| 适用环境 | 涉及哪个产品、版本、角色或地区? | Web 端、组织管理员、特定版本 |
| 观察信号 | 搜索和支持流程中发生了什么? | 无结果、未点击、搜索后提交工单 |
| 已核实原因 | 通过调查确认了什么? | 权限不足、产品故障、配置错误、尚未确认 |
建议的实施步骤:
保留原始搜索词,并记录可获得的角色、语言、产品和版本信息。
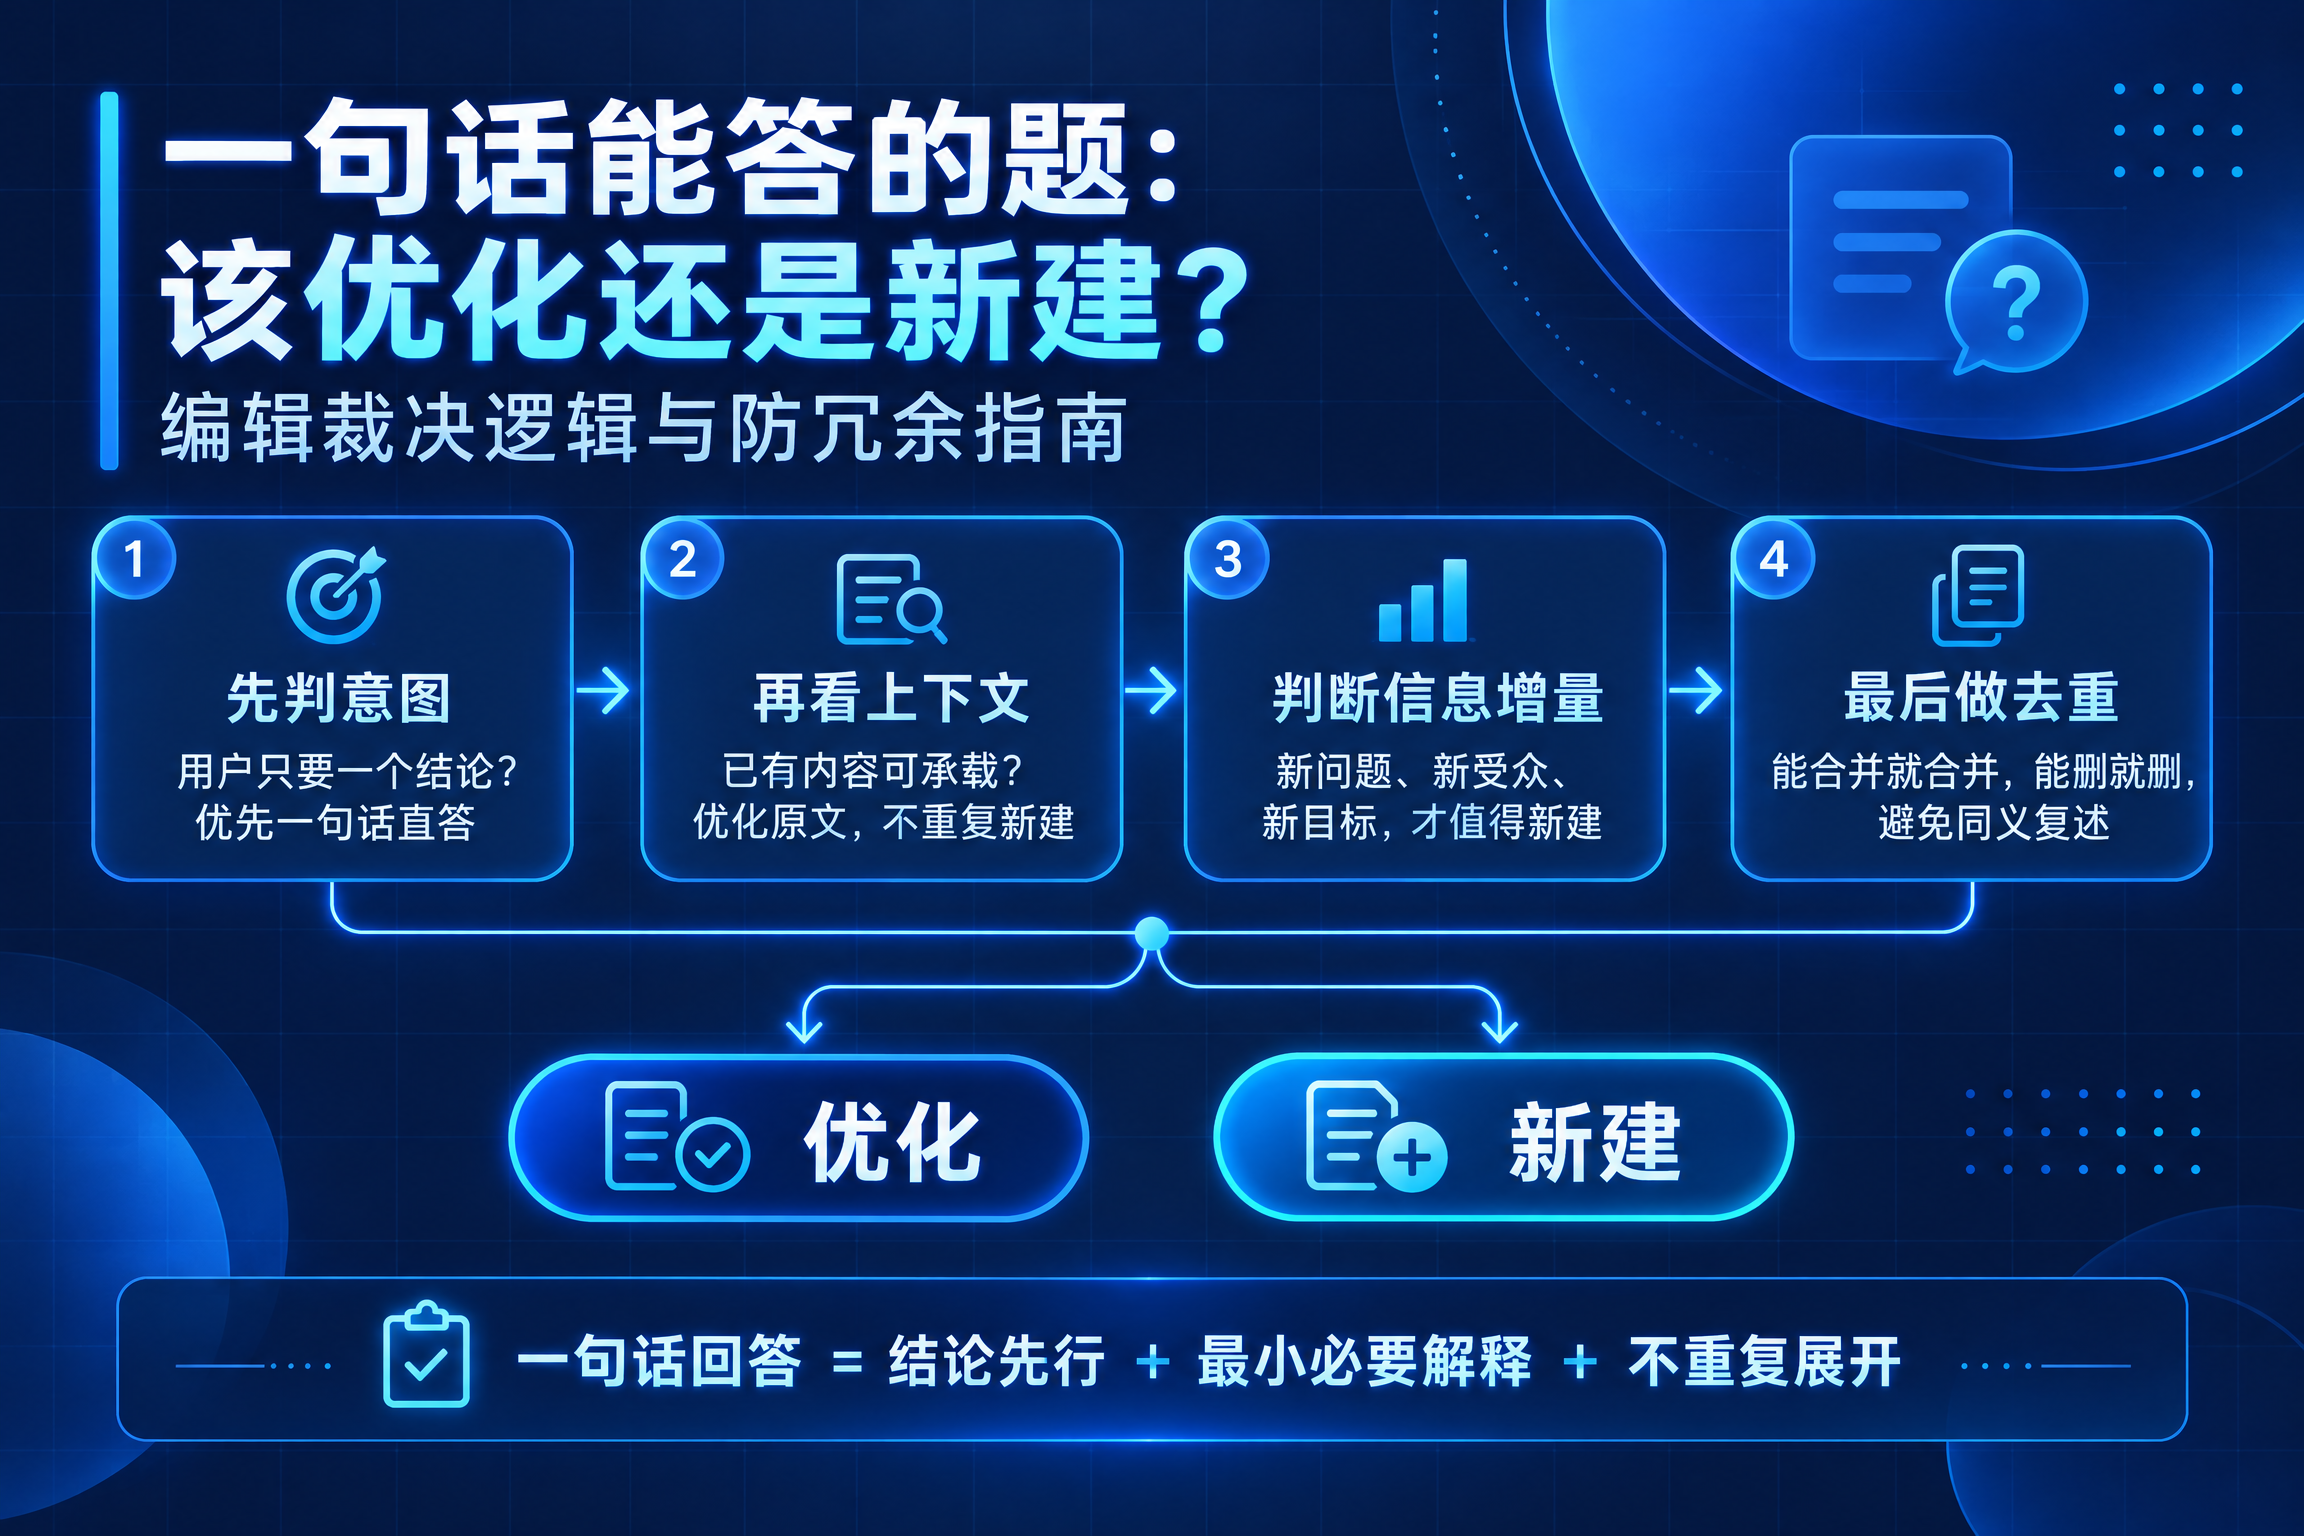
为查询标注操作、排错、入口查找或功能确认等意图;查询不明确时,允许标记为多意图或待确认。
单独记录搜索无结果、未点击及后续工单等行为,不把这些现象直接写成故障根因。
抽查相关工单、现有文章和产品状态,再选择内容优化、搜索调整、流程改进或产品排查。
用用户反馈和任务测试验证改动, 不只依据点击率或工单数量判断成功。
判断提醒:搜索后创建工单也可能是用户按指南完成了正确求助,低点击也可能来自摘要直接解答。相似问题反复出现,不能单独证明之前的解决方案无效。
一句话结论:先区分“用户想做什么”和“观察到了什么”,再核实“为什么发生”,才能制定有针对性的优化方案。
混合统计的陷阱:为什么“操作意图”与“故障反馈”不能混为一谈
混合统计会掩盖搜索日志与工单数据的关键差异,导致无法区分用户是想获取指引还是排查故障。
搜索日志能告诉你用户搜了什么,Zendesk 指标展示工单数量和点击率,TicketHub 摘要也能梳理出相似问题的趋势 [1][2]。这些工具看似提供了完整的数据拼图,却唯独缺了最关键的一环:端到端的搜索意图归并流程 [1]。
当运营者把“我想做什么”的操作需求,与“为什么失败”的故障反馈混在一起统计时,真实的用户痛点就被掩盖了 [3][4]。这就像把“找不到开关”和“开关坏了”记在同一行账本里,最终只能看到一个模糊的“设备难用”结论。这种混合统计会导致分析严重失真,让你无法分辨问题究竟源于用户的操作失误,还是产品功能本身不支持 [1]。
一旦数据被模糊化,基于此做出的优化决策就会失去针对性。若是操作失误,需要的是引导文案;若是功能缺失,则需要产品迭代。依赖单一的聚合热度指标,往往会让团队在错误的方向上浪费资源 [5]。因此,必须建立独立的分类机制,将具体的失败原因从泛化的查询中剥离出来,而非简单地将所有负面反馈视为同一类问题处理。
这里存在一个常被忽略的语境差异:在搜索日志中,“高频”往往被默认为“高价值”,但在故障场景下,高频搜索词恰恰可能代表系统性的体验断层。例如,当大量用户搜索“如何导出 CSV”时,如果直接将其归类为“教程需求”而撰写指南,可能会掩盖一个更严峻的事实——该功能在特定版本或权限下根本不可用,或者导出的文件格式与用户预期完全不符。这种“假性高热度”会误导团队投入资源去完善一个并不存在的流程,而真正的症结在于产品逻辑的断裂。只有将“想做”和“做不成”彻底拆开,才能看清哪些是学习成本问题,哪些是产品硬伤。
拆解四类核心维度:从查询词到可维护的问题单元
建立受证据约束的编辑机制,是将零散查询词转化为可维护问题单元、判定独立成篇价值的核心方法。
搜索日志里堆满了零散的词,Zendesk 报表里躺着各种指标,但没人直接告诉你如何把“一堆杂音”变成“一篇好文章”。真正的瓶颈不在于找不到问题,而在于判定何时值得独立成篇 [6][2]。要解决这个问题,必须建立一套受证据约束的编辑机制,将原始数据转化为可维护的问题单元 [4]。
归一化:还原用户的真实语言
第一步是清洗数据。用户输入的同义词、拼写错误、产品旧称或新称,甚至不同语言的表达,都需要映射到同一个候选问题上 [6][7]。这里有个陷阱:搜索引擎的自动补全功能会改变术语的匹配概率,那些被系统建议改写过的查询,不能直接当作用户的原始意图 [7]。如果盲目采信这些“被优化”的词,分析结果就会失真。
意图归并:区分“做什么”与“为什么不行”
第二步是将搜索意图归并彻底拆分开来。必须明确将“我想做什么”、“为什么失败”、“在哪里设置”以及“是否支持某条件”作为独立的类别处理 [3][4]。操作意图关注的是引导用户完成任务,而故障意图则聚焦于排查具体的阻碍,比如设置错误或条件不支持。混淆这两者,就像把“怎么做饭”和“饭烧焦了怎么办”混在一起统计,无法得出有效的改进策略。
下表展示了不同意图在数据处理上的核心差异:
| 对比项 | 操作意图(如“我想做什么”) | 故障意图(如“为啥失败”) | 混合统计的后果 |
|---|---|---|---|
| 核心目标 | 引导用户完成特定任务流程 | 排查具体阻碍原因 | 掩盖真实的失败根因 |
| 内容侧重 | 步骤指引、功能说明 | 错误代码、配置检查 | 解决方案泛化,缺乏针对性 |
| 成功指标 | 任务完成率、页面停留时长 | 问题解决率、工单关闭速度 | 无法准确评估内容有效性 |
| 优化方向 | 简化步骤、增加引导 | 修复逻辑漏洞、补充例外说明 | 资源浪费在无关细节上 |
| 数据来源 | 搜索日志中的高频指令词 | Zendesk 中的建单趋势与重复工单 | 数据噪音大,难以定位 |
对象定位与现象识别
第三步是利用 Brand、Search channel、User role、Locale 等过滤维度,将问题精准绑定到具体的产品模块或账户类型 [2]。没有对象定位,通用答案往往对特定群体无效。
最后一步是故障现象识别。不能简单合并为单一热度指标,而要区分“无结果”、“低点击”、“搜索后建单”和“重复工单”这四种不同的失败类型 [5][2]。这种四维分类法是基于搜索字段、工单趋势和意图知识库线索形成的工作框架 [1][3][2]。只有当这四个维度都清晰时,FAQ 体系才能从混乱走向有序。
为了验证这一维度的有效性,我们可以引入一个跨行业的参照案例:在电商平台的物流查询场景中,许多商家曾将“查不到包裹”和“不知道如何发货”混为一谈,导致客服话术混乱。后来通过拆分发现,“查不到”的用户中,70% 是因为填错了单号格式(操作失误),而 30% 是因为快递网点尚未揽收(系统状态延迟)。若不加区分地统一回复“请检查单号”,那 30% 等待揽收的用户会因为得不到解释而反复进线,导致工单量虚高。同理,在 SaaS 产品中,区分“不会用”和“不能用”是降低工单量的关键前提。
精准归因:识别具体失败原因以针对性优化
精准归因要求拆解具体失败原因,区分设置错误与功能不支持,从而为不同场景制定有效优化方案。
把“我想做什么”的操作意图和“为什么失败”的故障现象混在一起统计,就像把“找不到开关”和“灯坏了”当成同一个问题处理。前者需要指引步骤,后者需要排查硬件或权限。只有把具体失败原因拆解清楚,比如区分是设置错误还是功能不支持,才能制定出有效的优化策略 [3][4]。
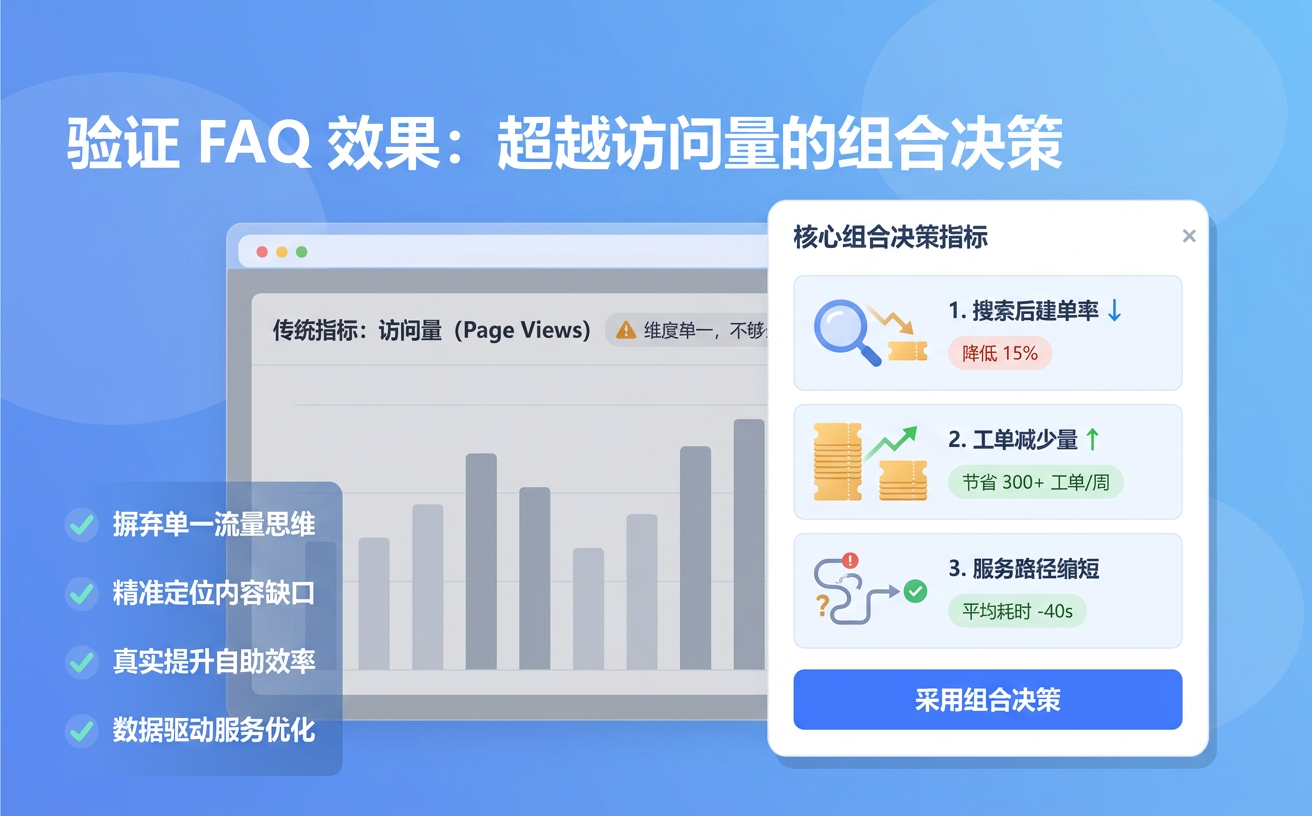
混合统计会掩盖真实的痛点。搜索日志能给出用户问了什么,Zendesk 指标能显示点击率和工单数量,但单纯看热度无法告诉你用户卡在哪一步 [1][2]。如果将“无结果”、“低点击”和“搜索后建单”合并为一个单一的热度指标,就会丢失关键信息。例如,一个高频搜索词可能因为产品不支持该条件而失败,也可能仅仅因为用户操作顺序错了。这两种情况需要的解决方案截然不同,混为一谈只会导致内容方向跑偏。
这种分类方法借用了 taxonomy 的思想,即通过分类和分解来辅助分析 [4]。但它并非通用的行业标准,而是一个受证据约束的编辑机制。四维分类(任务、意图、对象、故障现象)是基于搜索字段、工单趋势和意图知识库线索形成的工作框架,旨在解决 FAQ 选题瓶颈,而非被单一来源直接提出的规范 [1][3][2]。它要求编辑者像侦探一样,从零散的数据中还原出用户失败的真正逻辑。
为了更直观地展示不同失败类型对策略的影响,我们对比了两种典型场景的处理差异:
| 失败表现 | 潜在原因推测 | 若归类为“做啥”的错误后果 | 针对性优化策略 |
|---|---|---|---|
| 搜索无结果 | 功能暂不支持 | 误以为教程缺失,盲目撰写指南 | 明确标注功能状态,引导替代方案 |
| 搜索有结果但低点击 | 操作步骤复杂或入口隐蔽 | 误以为内容质量差,反复修改文案 | 优化 UI 交互,简化操作路径 |
| 搜索后大量建单 | 设置错误或环境限制 | 误以为产品缺陷,投入研发修复 | 补充前置检查清单,强化引导提示 |
这种基于证据的分类法,让每一个 FAQ 选题都有据可依。它不追求完美的理论模型,而是致力于在混乱的数据中建立清晰的行动路径。当你不再用“热度”作为唯一标尺,而是深入剖析每一次搜索背后的真实阻碍时,内容体系才能真正从混乱走向有序。
实操建议:如果你正在着手优化 FAQ 体系,不要试图一次性清理所有历史数据。建议先从最近一周的 Zendesk 工单中,提取 Top 10 的“搜索后建单”关键词,人工复核每个工单的上下文。尝试将它们重新打标为“操作失误”或“功能缺失/不支持”。你会发现,原本看似杂乱无章的“用户不满意”,瞬间变成了两条清晰的行动线:一条指向文案优化,另一条指向产品文档或功能改进。这种小范围的试点能让你迅速验证分离统计的价值,而无需推翻现有的整个数据架构。
从混乱数据到清晰策略:构建可维护的 FAQ 体系
FAQ 选题的真正瓶颈,往往不在于发现零散问题,而在于判定何时值得将其独立成篇 [6][2]。若将“做啥”的操作意图与“为啥失败”的故障现象混为一谈,分析结果必然失真,导致决策依据模糊 [5]。唯有坚持分离原则,才能把相似搜索词归并为真正可维护的问题单元。
这种分类方法本质上是一种受证据约束的编辑机制,它填补了当前缺乏端到端流程的空白 [1][6][2]。通过意图归并与故障现象识别,团队能将搜索日志、工单数据与用户反馈串联起来,从而提升决策支持的有效性 [4]。当我们将“无结果”“低点击”或“重复工单”视为不同类型的失败信号时,优化方向便不再是大海捞针,而是有的放矢。
最终,构建清晰的 FAQ 体系需要严格遵循意图与故障的分离逻辑。这并非某种被验证的行业标准,而是在现有数据碎片中,解决从搜索词到独立选题这一关键路径的最务实方案 [4][2]。只有拆解清楚,策略才能落地。
常见问题解答 (FAQ)
Q: 为什么不能直接用搜索热度来决定写什么内容?A: 高热度可能源于“不知道怎么做”(操作意图),也可能源于“根本做不到”(故障意图)。如果不区分,你可能花大力气写了一篇详细的操作指南,但用户其实是因为功能缺失才搜索的,这样不仅浪费资源,还无法解决问题。
Q: “搜索后建单”和“重复工单”有什么区别?A: “搜索后建单”通常意味着用户在自助服务(如搜索或阅读文章)后仍未找到答案,转而寻求人工帮助;而“重复工单”则暗示之前的解决方案无效或未被理解。两者虽然都是负面信号,但前者指向内容缺失,后者指向内容质量或流程缺陷。
Q: 如何开始实施“故障现象识别”?A: 不要只看总数。试着将工单按“无结果”、“低点击”、“搜索后建单”和“重复发生”进行打标。你会发现,原本笼统的“用户不满意”会变成四个清晰的可执行任务列表。
参考来源
TicketHub: Enabling Actionable Analysis of Support Requests With NLP · https://dl.acm.org/doi/fullHtml/10.1145⁄3569951.3604397(S级)
Analyzing help center search results · https://support.zendesk.com/hc/en-us/articles/4408818465562-Analyzing-help-center-search-results(B级)
IntentsKB | Proceedings of the 27th ACM International Conference on Information and Knowledge Management · https://dl.acm.org/doi/10.1145⁄3269206.3269257(S级)
A Cognitively-Based Functional Taxonomy of Decision Support Techniques | ACM SIGCHI Bulletin · https://dl.acm.org/doi/10.1145⁄28189.1044805(S级)
7 Ways to Improve Your Website’s or Intranet’s Built-In Search Engine - NN/G · https://www.nngroup.com/articles/internal-website-search/(B级)
Search-Log Analysis: The Most Overlooked Opportunity in Web UX Research - NN/G · https://www.nngroup.com/articles/search-log-analysis/(B级)
Site Search Suggestions - NN/G · https://www.nngroup.com/articles/site-search-suggestions/(B级)